
▶ 本报记者 张伟
7月9-11日,以“智算无界,范式跃迁”为主题的海光产业生态合作组织(简称“光合组织”)2026智能计算应用大会,在河南省郑州市举办。大会围绕智能计算应用与发展范式、AI(人工智能)基础设施创新、国产开放计算生态建设等展开探讨交流,旨在推动国产人工智能算力从关注建设向关注应用转变,从评价单一参数向注重系统能力转变,从局部场景向大规模迁移迈进。
“国产AI算力已经从‘能不能用’的阶段,进入‘好不好用、能不能规模化落地’的应用检验期。”会上,多位参会人士表示,随着政策支持、产业链协同和软硬件生态逐步完善,国产芯片、服务器、系统软件及应用生态正在加快融合,推动AI算力在科研、金融、教育、能源等场景落地。
进入十万卡时代
当前,智能应用正在引爆全球各行业变革,亟需构建自主、安全、先进的算力应用底座。
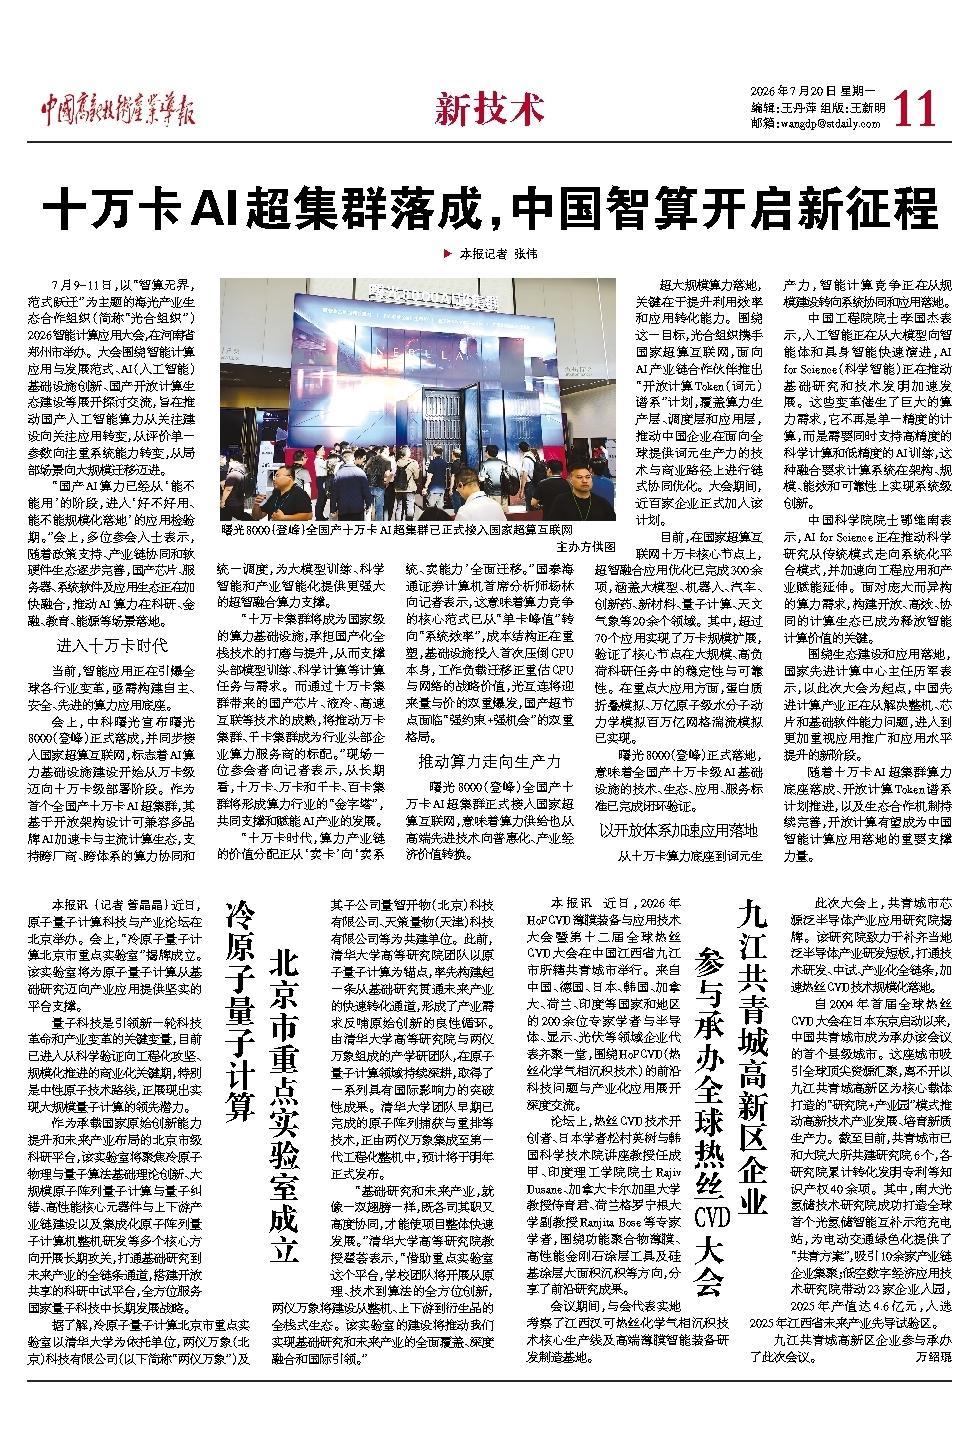
会上,中科曙光宣布曙光8000(登峰)正式落成,并同步接入国家超算互联网,标志着AI算力基础设施建设开始从万卡级迈向十万卡级部署阶段。作为首个全国产十万卡AI超集群,其基于开放架构设计可兼容多品牌AI加速卡与主流计算生态,支持跨厂商、跨体系的算力协同和统一调度,为大模型训练、科学智能和产业智能化提供更强大的超智融合算力支撑。
“十万卡集群将成为国家级的算力基础设施,承担国产化全栈技术的打磨与提升,从而支撑头部模型训练、科学计算等计算任务与需求。而通过十万卡集群带来的国产芯片、液冷、高速互联等技术的成熟,将推动万卡集群、千卡集群成为行业头部企业算力服务商的标配。”现场一位参会者向记者表示,从长期看,十万卡、万卡和千卡、百卡集群将形成算力行业的“金字塔”,共同支撑和赋能AI产业的发展。
“十万卡时代,算力产业链的价值分配正从‘卖卡’向‘卖系统、卖能力’全面迁移。”国泰海通证券计算机首席分析师杨林向记者表示,这意味着算力竞争的核心范式已从“单卡峰值”转向“系统效率”,成本结构正在重塑,基础设施投入首次压倒GPU本身,工作负载迁移正重估CPU与网络的战略价值,光互连将迎来量与价的双重爆发,国产超节点面临“强约束+强机会”的双重格局。
推动算力走向生产力
曙光8000(登峰)全国产十万卡AI超集群正式接入国家超算互联网,意味着算力供给也从高端先进技术向普惠化、产业经济价值转换。
超大规模算力落地,关键在于提升利用效率和应用转化能力。围绕这一目标,光合组织携手国家超算互联网,面向AI产业链合作伙伴推出“开放计算Token(词元)谱系”计划,覆盖算力生产层、调度层和应用层,推动中国企业在面向全球提供词元生产力的技术与商业路径上进行链式协同优化。大会期间,近百家企业正式加入该计划。
目前,在国家超算互联网十万卡核心节点上,超智融合应用优化已完成300余项,涵盖大模型、机器人、汽车、创新药、新材料、量子计算、天文气象等20余个领域。其中,超过70个应用实现了万卡规模扩展,验证了核心节点在大规模、高负荷科研任务中的稳定性与可靠性。在重点大应用方面,蛋白质折叠模拟、万亿原子级水分子动力学模拟百万亿网格湍流模拟已实现。
曙光8000(登峰)正式落地,意味着全国产十万卡级AI基础设施的技术、生态、应用、服务标准已完成闭环验证。
以开放体系加速应用落地
从十万卡算力底座到词元生产力,智能计算竞争正在从规模建设转向系统协同和应用落地。
中国工程院院士李国杰表示,人工智能正在从大模型向智能体和具身智能快速演进,AI for Science(科学智能)正在推动基础研究和技术发明加速发展。这些变革催生了巨大的算力需求,它不再是单一精度的计算,而是需要同时支持高精度的科学计算和低精度的AI训练,这种融合要求计算系统在架构、规模、能效和可靠性上实现系统级创新。
中国科学院院士鄂维南表示,AI for Science正在推动科学研究从传统模式走向系统化平台模式,并加速向工程应用和产业赋能延伸。面对庞大而异构的算力需求,构建开放、高效、协同的计算生态已成为释放智能计算价值的关键。
围绕生态建设和应用落地,国家先进计算中心主任历军表示,以此次大会为起点,中国先进计算产业正在从解决整机、芯片和基础软件能力问题,进入到更加重视应用推广和应用水平提升的新阶段。
随着十万卡AI超集群算力底座落成、开放计算Token谱系计划推进,以及生态合作机制持续完善,开放计算有望成为中国智能计算应用落地的重要支撑力量。